우리는 지금까지 마스터 데이터 관리(MDM) 환경을 보호하기 위해 접근 권한(RBAC)을 통제하고, 스토리지 데이터를 암호화(KMS)하며, 엔드포인트의 유출 경로(DLP)를 철통같이 차단하는 강력한 3중 방어선을 구축했습니다.
하지만 제로 트러스트(Zero Trust) 보안 아키텍처의 관점에서 보면, ‘내부의 적’은 언제나 존재합니다. 합법적인 최고 권한을 가진 데이터베이스 관리자나 임원 계정이 탈취되었을 때, 이 방어선들은 무용지물이 될 수 있습니다. 따라서 엔터프라이즈 보안의 최종 완성은 완벽한 방어를 넘어, “누가, 언제, 어디서, 무엇을, 어떻게 했는가?”를 단 하나의 누락도 없이 낱낱이 기록하고 실시간으로 감시하는 것에 있습니다.
본 문서에서는 글로벌 컴플라이언스(ISO 27001, GDPR, HIPAA 등)에서 가장 깐깐하게 평가하는 시스템 감사 트레일(Audit Trail) 로깅 아키텍처의 실무적 구축 방안과, 법적 분쟁 시 증거 능력을 갖추기 위한 로그 무결성(Integrity) 검증 기술을 심층 분석합니다.
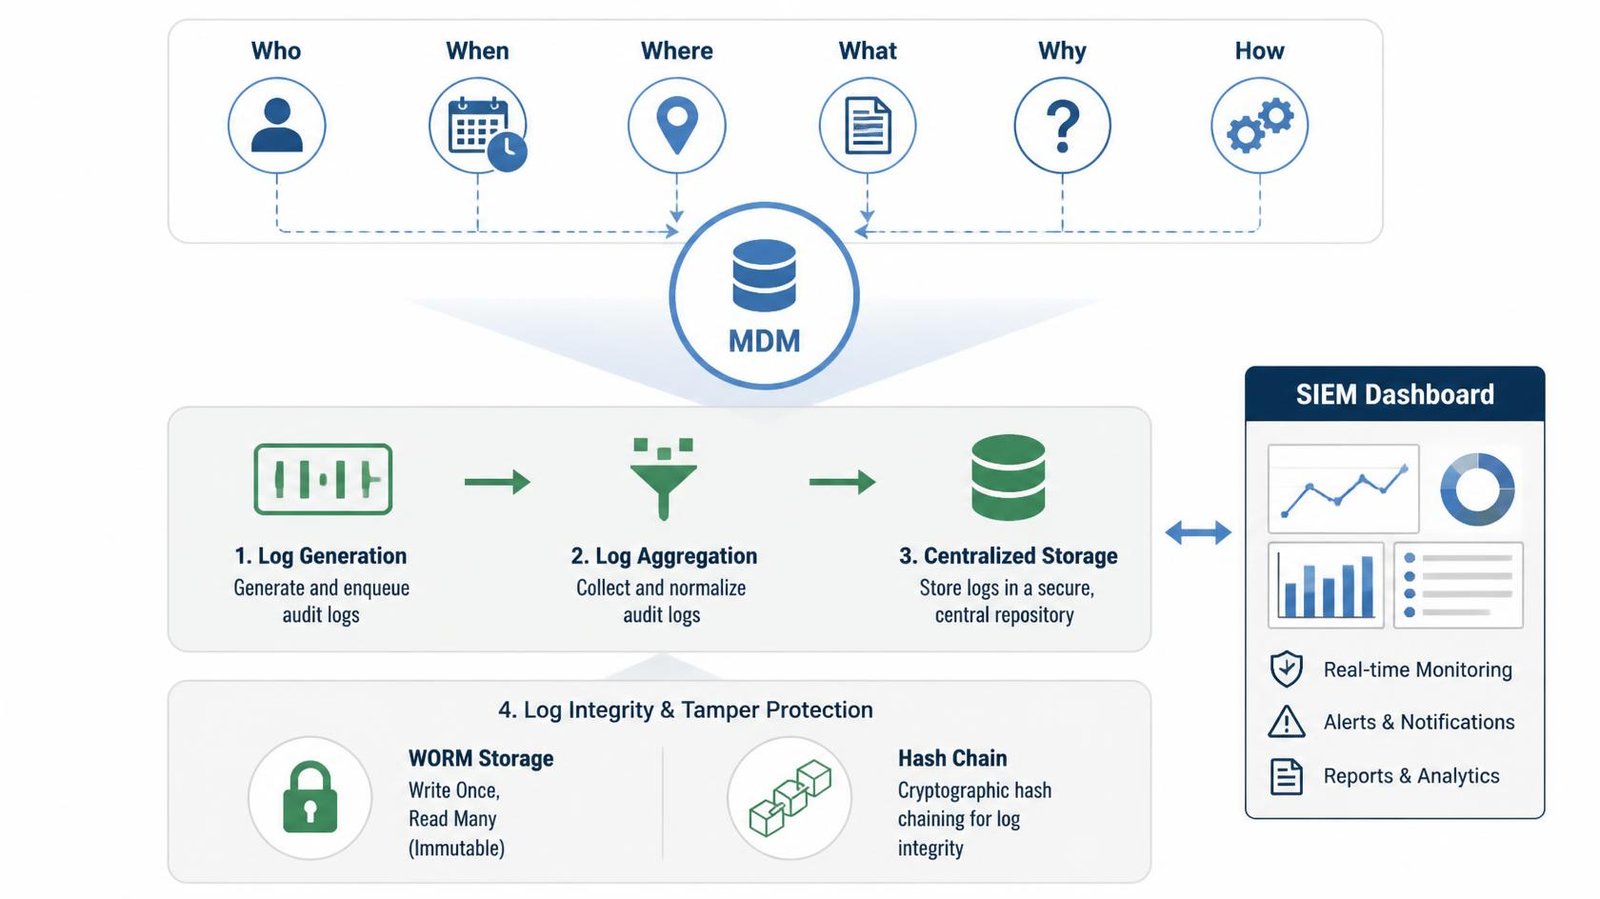
1. 단순 시스템 로그를 넘어선 ‘감사 트레일(Audit Trail)’의 6W1H 요건
서버가 다운되거나 에러가 났을 때 개발자가 보는 ‘시스템 로그(System Log)’와 보안 감사를 위한 ‘감사 트레일(Audit Trail)’은 그 목적과 수준이 완전히 다릅니다. 법적 효력을 갖는 완벽한 감사 로그는 다음의 6W 요소를 반드시 정형화된 포맷(JSON 등)으로 포함해야 합니다.
- Who (주체): 행위를 수행한 사용자의 명확한 사번(ID) 및 당시 할당된 세션 역할(Role). (단순히 ‘Admin’이 아니라 ‘Admin 권한을 위임받은 홍길동’으로 식별되어야 함)
- When (시간): 글로벌 표준 타임서버(NTP)와 밀리초(ms) 단위까지 동기화된 정확한 발생 일시(Timestamp).
- Where (위치): 접근이 발생한 출발지 IP 주소, MAC 주소, VPN 접속 여부 및 기기(Device) 정보.
- What (객체): 조회, 수정, 삭제된 구체적인 마스터 데이터의 식별값(예: 고객 번호 CUST-9982, 특정 제품 코드).
- Why/How (행위 및 결과): 수행한 데이터베이스 트랜잭션의 종류(Create, Read, Update, Delete) 및 해당 작업의 최종 성공/실패(Denied) 여부.
[실무 팁] 실패한 접근 시도(Access Denied)를 기록하는 것이 성공한 로그를 기록하는 것보다 침해 사고 징후를 파악하는 데 훨씬 더 중요합니다.
2. 대용량 MDM 환경을 위한 ‘비동기 분산 로깅 아키텍처’ 설계
초당 수천 건의 트랜잭션이 발생하는 MDM 환경에서, 데이터베이스에 직접 감사 로그를 쌓는(Write) 행위는 심각한 디스크 I/O 병목(Bottleneck) 현상과 서비스 지연을 초래합니다. 따라서 실무에서는 시스템의 성능을 갉아먹지 않는 분산 아키텍처를 설계해야 합니다.
- 로그 생성 (Log Generation) 및 메시지 큐 대기: 애플리케이션 단에서 발생하는 이벤트를 비동기(Asynchronous) 방식으로 캡처합니다. 생성된 로그는 즉시 DB에 저장되지 않고, 아파치 카프카(Apache Kafka)나 래빗MQ(RabbitMQ)와 같은 고성능 메시지 큐(Message Queue)에 버퍼링되어 대기합니다. 이를 통해 본연의 마스터 데이터 처리 성능을 100% 유지할 수 있습니다.
- 로그 수집 및 정제 (Log Aggregation & Parsing): Logstash나 Fluentd와 같은 전문 로그 수집기가 여러 시스템에서 쏟아지는 원시 로그(Raw Log)를 중앙으로 빨아들입니다. 이때 불필요한 시스템 노이즈를 제거하고, SIEM이 읽을 수 있는 표준화된 포맷으로 가공(Parsing)합니다.
- 중앙 집중식 저장소 (Centralized Log Repository): 정제된 대용량 로그를 엘라스틱서치(Elasticsearch)와 같은 검색 엔진 기반 스토리지에 분산 저장하여, 수억 건의 로그 속에서도 즉각적인 풀텍스트 검색(Full-text Search)이 가능하도록 구성합니다.
3. 사후 증적 확보의 끝판왕: ‘로그 무결성(Integrity)’ 검증 기술
해커가 지능형 지속 위협(APT)을 통해 시스템 장악에 성공했을 때, 가장 먼저 시도하는 일은 자신의 더러운 발자국(로그)을 지우거나 조작하는 것입니다. 저장된 감사 트레일은 ‘한 번 기록되면 최고 관리자(Root)조차 절대 수정하거나 삭제할 수 없는 상태’를 유지해야 하며, 이를 기술적으로 보장하는 것이 아키텍처의 핵심입니다.
- WORM (Write Once, Read Many) 스토리지의 활용: AWS S3의 객체 잠금(Object Lock) 기능이나 온프레미스의 전용 광학 스토리지 장비를 활용합니다. 컴플라이언스 모드를 적용하면, 지정된 법정 보존 기간(예: 3년~5년) 동안에는 아마존 클라우드 관리자조차 물리적으로 로그 파일을 삭제하거나 덮어쓸 수 없도록 강제됩니다.
- 해시 체이닝(Hash Chaining) 기법 도입: 블록체인(Blockchain)의 원리를 로그 시스템에 적용한 고도화된 기술입니다. 이전 로그 파일의 해시(Hash)값을 다음 로그 파일의 생성에 꼬리표처럼 포함시킵니다. 만약 내부자가 과거의 특정 로그 파일 단 하나라도 몰래 텍스트를 변조한다면, 그 이후로 이어지는 모든 체인의 해시값이 어긋나게 됩니다. 이는 디지털 포렌식 과정에서 데이터가 단 1비트도 조작되지 않았음을 수학적으로 완벽하게 입증하는 가장 강력한 법적 증거 자료가 됩니다.
4. 파이썬 Logging으로 구현하는 데이터 리니지 역추적 실무
많은 초보자들이 파이썬 스크립트에 print() 함수를 도배하여 진행 상황을 확인합니다. 하지만 이는 콘솔 창이 닫히는 순간 영원히 휘발되는 무의미한 텍스트일 뿐, 거버넌스 관점의 ‘감사(Audit)’ 증적이 될 수 없습니다.
실제 운영 환경에서는 파일 용량이 무한정 커지는 것을 방지하고, 에러의 심각도(Level)를 구분하며, 훗날 ELK(Elasticsearch, Logstash, Kibana) 스택과 연동할 수 있는 구조화된 로깅이 필수적입니다.
다음은 원시 데이터가 브론즈 ➔ 실버 ➔ 골드 존으로 이동하는 모든 변환(Transformation) 과정을 타임스탬프와 함께 물리적 파일로 영구 보존하는 실전 스크립트입니다. RotatingFileHandler를 적용하여 로그 파일 관리를 자동화한 것이 핵심입니다.
Python
import logging
from logging.handlers import RotatingFileHandler
import os
import pandas as pd

# 1. 엔터프라이즈급 감사 트레일 로거(Logger) 설정
def setup_audit_logger():
    logger = logging.getLogger("DataGovernanceAudit")
    logger.setLevel(logging.DEBUG)

    log_dir = "./audit_logs"
    os.makedirs(log_dir, exist_ok=True)

    # RotatingFileHandler: 파일 하나당 최대 5MB로 제한, 백업본 3개 유지 (디스크 터짐 방지)
    log_file = f"{log_dir}/pipeline_audit_trail.log"
    file_handler = RotatingFileHandler(log_file, maxBytes=5*1024*1024, backupCount=3, encoding='utf-8')

    # 로그 포맷: [타임스탬프] [로그레벨] [모듈명:라인번호] - 메타데이터 및 메시지
    formatter = logging.Formatter('%(asctime)s [%(levelname)s] [%(filename)s:%(lineno)d] - %(message)s')
    file_handler.setFormatter(formatter)

    # 콘솔 출력 핸들러 설정
    console_handler = logging.StreamHandler()
    console_handler.setFormatter(formatter)

    if not logger.handlers:
        logger.addHandler(file_handler)
        logger.addHandler(console_handler)

    return logger

# 2. 부동산 단지 정보 및 G2B 데이터 파이프라인 리니지 기록
def process_and_track_lineage(raw_dataframe):
    audit_logger = setup_audit_logger()
    audit_logger.info("==================================================")
    audit_logger.info("TRANSACTION START: G2B 공공입찰 데이터 파이프라인 가동")
    audit_logger.info(f"[Bronze Zone] 원시 데이터 {len(raw_dataframe)}건 수집 완료")

    try:
        # 단계 1: 실버 존(Silver Zone) - DQI 결측치 통제
        audit_logger.info("[Silver Zone - DQI] 완전성(Completeness) 스캔 시작")
        initial_count = len(raw_dataframe)

        # 고의적인 결측치 처리
        df_cleaned = raw_dataframe.dropna(subset=['기초금액', '입찰공고명'])
        dropped_count = initial_count - len(df_cleaned)

        if dropped_count > 0:
            audit_logger.warning(f"[Quality Gate Fail] 결측치 {dropped_count}건 발견. Quarantine(격리) 폴더로 이관 조치함.")
        else:
            audit_logger.info("[Quality Gate Pass] 결측치 없음. 무결성 확인 완료.")

        # 단계 2: 실버 존(Silver Zone) - MDM 단일 진실 공급원(SSOT) 매핑
        audit_logger.info("[Silver Zone - MDM] 파편화 데이터 퍼지 매칭(Fuzzy Matching) 시작")
        # (퍼지 매칭 병합 로직 가동 구간)
        audit_logger.info("[MDM 병합 완료] 비표준 단지명을 마스터 골든 레코드로 변환 성공")

        # 단계 3: 골드 존(Gold Zone) 적재 완료
        audit_logger.info(f"[Gold Zone] 최종 정제된 마스터 데이터 {len(df_cleaned)}건 DW 적재 준비 완료")
        audit_logger.info("TRANSACTION END: 파이프라인 정상 종료")

        return df_cleaned

    except Exception as e:
        # 치명적 장애 발생 시 Stack Trace를 포함하여 Error 레벨로 기록
        audit_logger.error(f"[FATAL ERROR] 파이프라인 중단: {str(e)}", exc_info=True)
        raise

# 스크립트 테스트 구동
if __name__ == "__main__":
    # 고의로 Null 값을 포함시킨 더미 데이터 (스트레스 테스트)
    dummy_data = pd.DataFrame({
        '입찰공고명': ['미사강변푸르지오 도색', '하남미사롯데캐슬 조경', None],
        '기초금액': [15000000, 23000000, pd.NA],
    })
    process_and_track_lineage(dummy_data)
위 파이프라인을 실행하면 생성되는 pipeline_audit_trail.log 파일을 열어보십시오. 원시 데이터 3건이 유입되었고, 품질 게이트에서 1건의 불량 데이터가 어떻게 격리되었으며, 최종적으로 2건만이 골드 존으로 안착했는지 그 숨 막히는 데이터 리니지(Data Lineage)가 타임스탬프 단위로 투명하게 기록되어 있습니다.
이러한 시스템 감사 트레일은 단순한 디버깅 도구를 넘어섭니다. “왜 어제자 입찰 공고가 대시보드에 안 보이지?”라는 의문이 생겨도 당황할 필요가 없습니다. 로그 파일만 열면 “해당 데이터는 발주처의 기초금액 누락으로 품질 게이트에서 22시 15분에 격리되었다”는 사실을 바로 확인할 수 있습니다. 투명한 추적성 확보야말로 진정한 데이터 거버넌스의 종착지입니다.
5. 결론: 감시의 시각화가 곧 최선의 방어다
시스템 감사 트레일은 외부 심사관에게 보여주기 위한 귀찮은 규제 준수(Compliance) 요건에 머물러서는 안 됩니다. 촘촘하게 짜인 로깅 아키텍처와 이를 시각화한 대시보드는 내부 임직원들에게 “나의 모든 데이터 접근 행위가 투명하게 기록되고 있다”는 강력한 심리적 경각심을 줍니다. 이는 잠재적인 데이터 유출 및 일탈 시도를 사전에 억제하는 가장 훌륭하고 효과적인 통제 수단입니다.
지금까지 우리는 마스터 데이터를 겹겹이 보호하고 24시간 감시하는 거버넌스와 보안 아키텍처의 험난한 산을 모두 정복했습니다. 이제 우리의 시선은 이 거대한 시스템이 현업의 요구에 맞춰 얼마나 빠르고 쾌적하게 돌아갈 수 있는지, ‘성능 최적화(Performance Tuning)’의 영역으로 향해야 합니다.
다음편에서는 대용량 마스터 데이터를 다룰 때 필연적으로 발생하는 ‘MDM 시스템 배치 프로세스(Batch Process)의 성능 병목 지점 진단 및 튜닝’ 기법에 대해 실무적인 관점에서 깊이 있게 파헤쳐 보겠습니다.

경기도 하남 미사에서 부동산 중개 비즈니스를 운영하며 G2B 공공입찰 데이터 파이프라인을 직접 설계한 데이터 엔지니어입니다. 18년간 수학 교육 현장에서 다져온 논리적 사고력으로 데이터 거버넌스와 MDM을 다룹니다.
https://jjubis.com/about-jjubis/