넘볼 수 없는 광활한 핫존: 소수점 네 자리의 함정

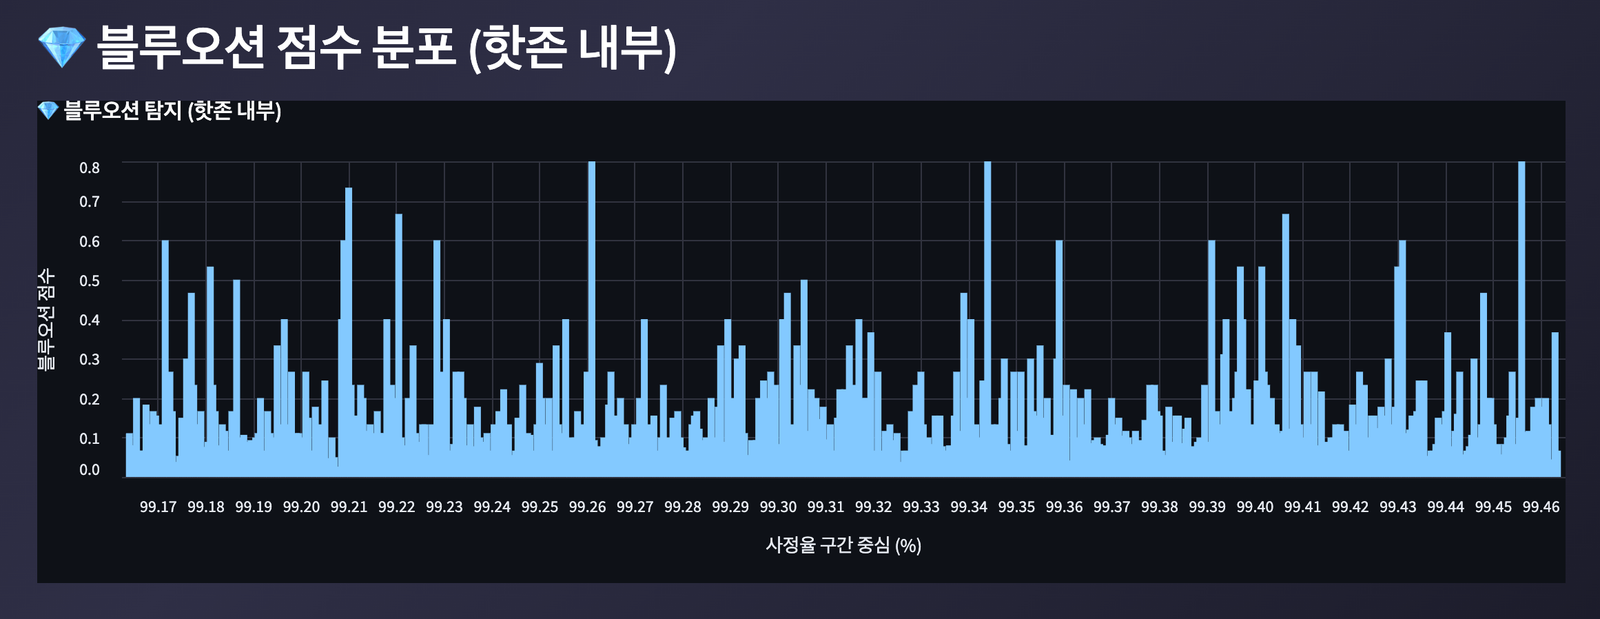
사정율 구간(99.17~99.46%)별 낙찰 밀도 분포를 보여주는 히스토그램

“이해를 돕기 위해 재구성한 예시 화면입니다” 1편에서 이야기한 업체명 매칭 문제를 해결하고 나니, 이제 진짜 궁금했던 걸 볼 차례였습니다. 특정 집행관의 과거 낙찰 기록을 모아서, 그 집행관 손에서 유독 자주 낙찰이 나던 사정율 구간 — 이른바 ‘핫존’을 찾아내는 작업이었습니다. 첫 시도는 단순했습니다. 과거 낙찰 데이터를 쭉 훑어보고, 눈에 띄게 낙찰이 몰려 있는 구간을 대략 잡았습니다. … 더 읽기
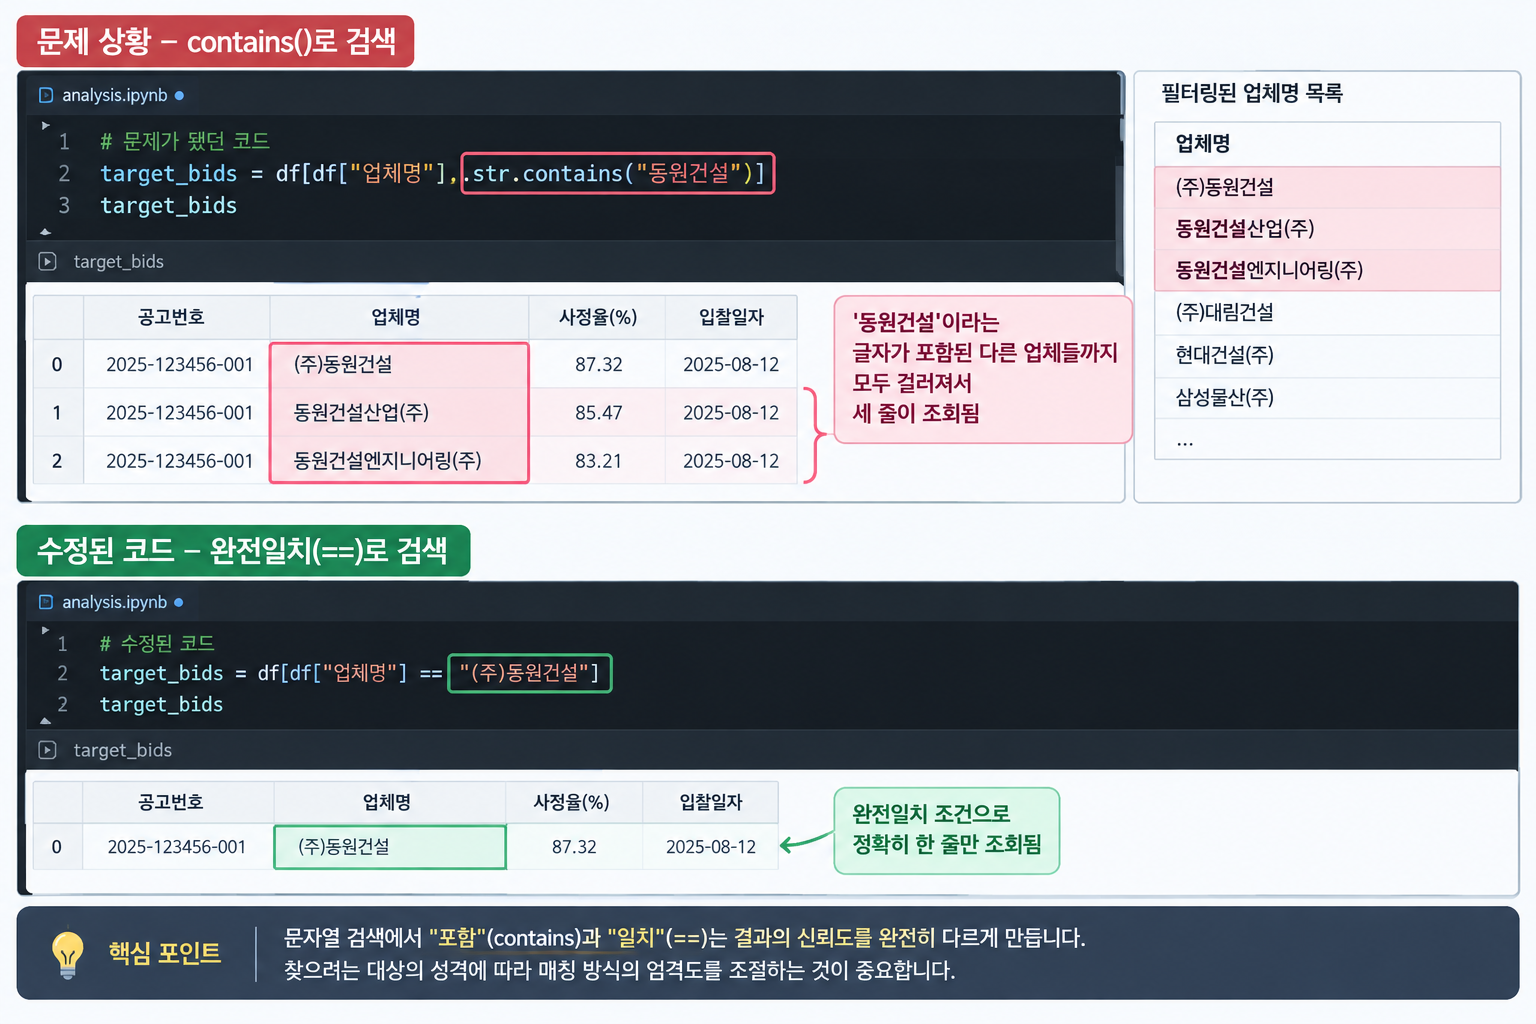
한 건이어야 할 결과가 세 건으로 나왔다: 입찰 데이터가 가르쳐준 첫 번째 교훈

1365분석기 오류 해결 썸네일1

(대표 이미지는 이해를 돕기 위해 재구성한 예시 화면입니다.) 정보통신공사업 관련 입찰건에 대해 낙찰예정가를 분석해달라는 의뢰를 받은 적이 있습니다. 이를 위해 공공데이터포털에서 나라장터 입찰공고 API를 발급받고, 관련 데이터를 긁어와서 취합하는 파이프라인을 짜기 시작했습니다. 분석 과정 중에는 특정 업체 하나의 과거 입찰 참가 이력을 정확히 추적해야 하는 작업도 포함되어 있었는데, 여기서 예상 못 한 곳에 발목을 잡혔습니다. … 더 읽기

마스터 데이터 관리(MDM) 통합 실무: 파이썬 퍼지 매칭(Fuzzy Matching)을 활용한 파편화 데이터 병합과 단일 진실 공급원(SSOT) 구축

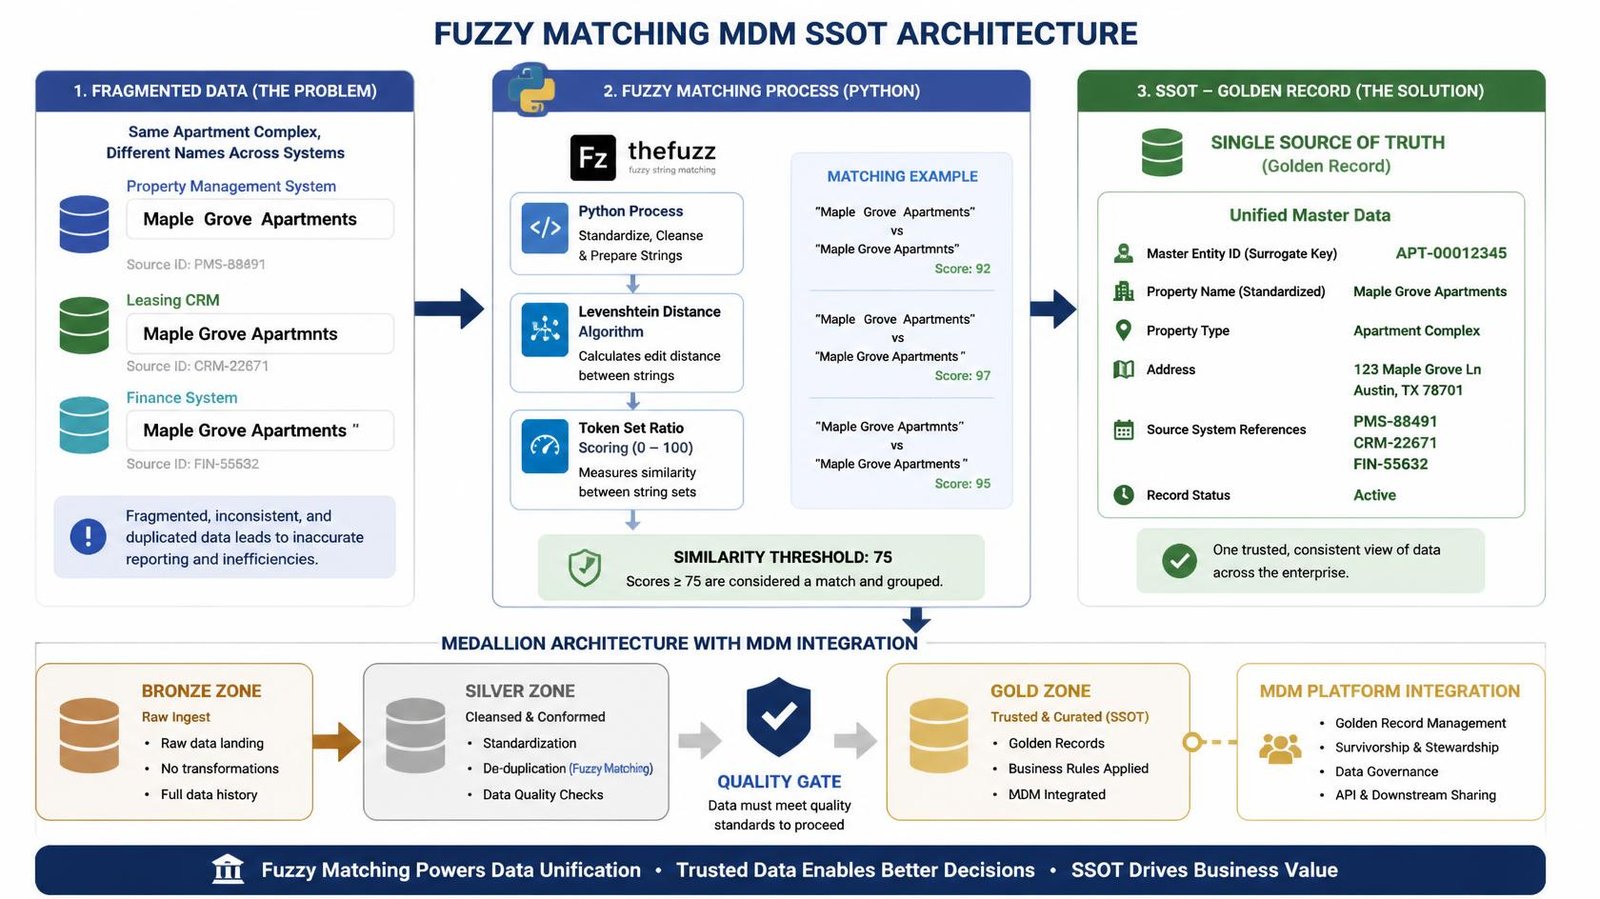
Fuzzy matching MDM SSOT architecture diagram

엔터프라이즈 환경에서 데이터 거버넌스와 데이터 레이크를 완벽하게 구축했더라도, 피할 수 없는 최후의 장벽이 하나 존재합니다. 바로 여러 시스템에서 유입된 데이터들의 ‘명칭 불일치’로 인한 파편화(Fragmentation) 현상입니다. 아무리 철저하게 결측치를 막아내고 포맷을 통일(DQI)하더라도, 본질적으로 입력된 ‘이름’ 자체가 제각각이라면 시스템은 이를 완전히 다른 데이터로 인식해 버립니다. 본 문서에서는 파이썬(Python) 데이터 엔지니어링의 핵심 기술인 퍼지 매칭(Fuzzy Matching)을 활용하여, 뿔뿔이 … 더 읽기

데이터 레이크 거버넌스(Data Lake Governance) 실무: 통제 불능의 ‘데이터 늪(Data Swamp)’ 탈출과 메달리온 아키텍처

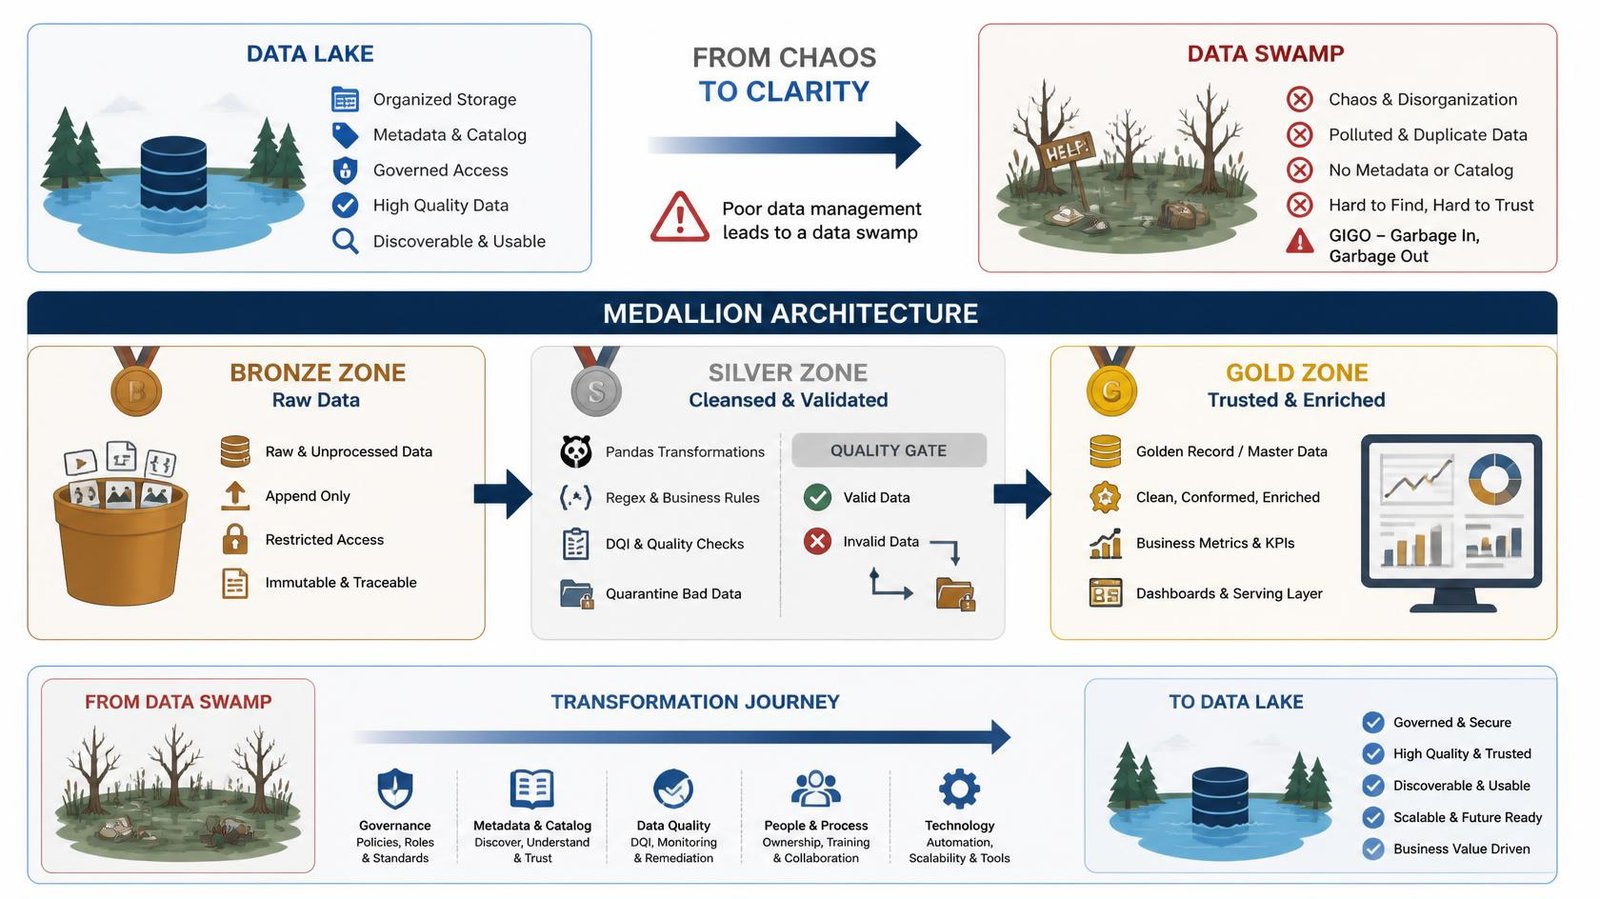
Data lake to data swamp transformation and medallion architecture diagram

최근 엔터프라이즈 데이터 엔지니어링의 가장 큰 화두는 단연 ‘데이터 레이크(Data Lake)’입니다. 하지만 AWS S3나 하둡(Hadoop) 같은 거대한 스토리지를 열어두고 원시 데이터(Raw Data)를 무작정 쏟아붓는다고 해서 빅데이터 인프라가 완성되는 것은 아닙니다. 명확한 통제 규칙과 아키텍처 없이 방치된 데이터 레이크는 머지않아 누구도 쓸모 있는 정보를 찾을 수 없고 악취만 진동하는 ‘데이터 늪(Data Swamp)’으로 전락하고 맙니다. 본 문서에서는 … 더 읽기

더미데이터(Dummy Data) 뜻과 파이썬 Faker를 활용한 공공입찰(G2B) 스트레스 테스트 데이터 생성 실무

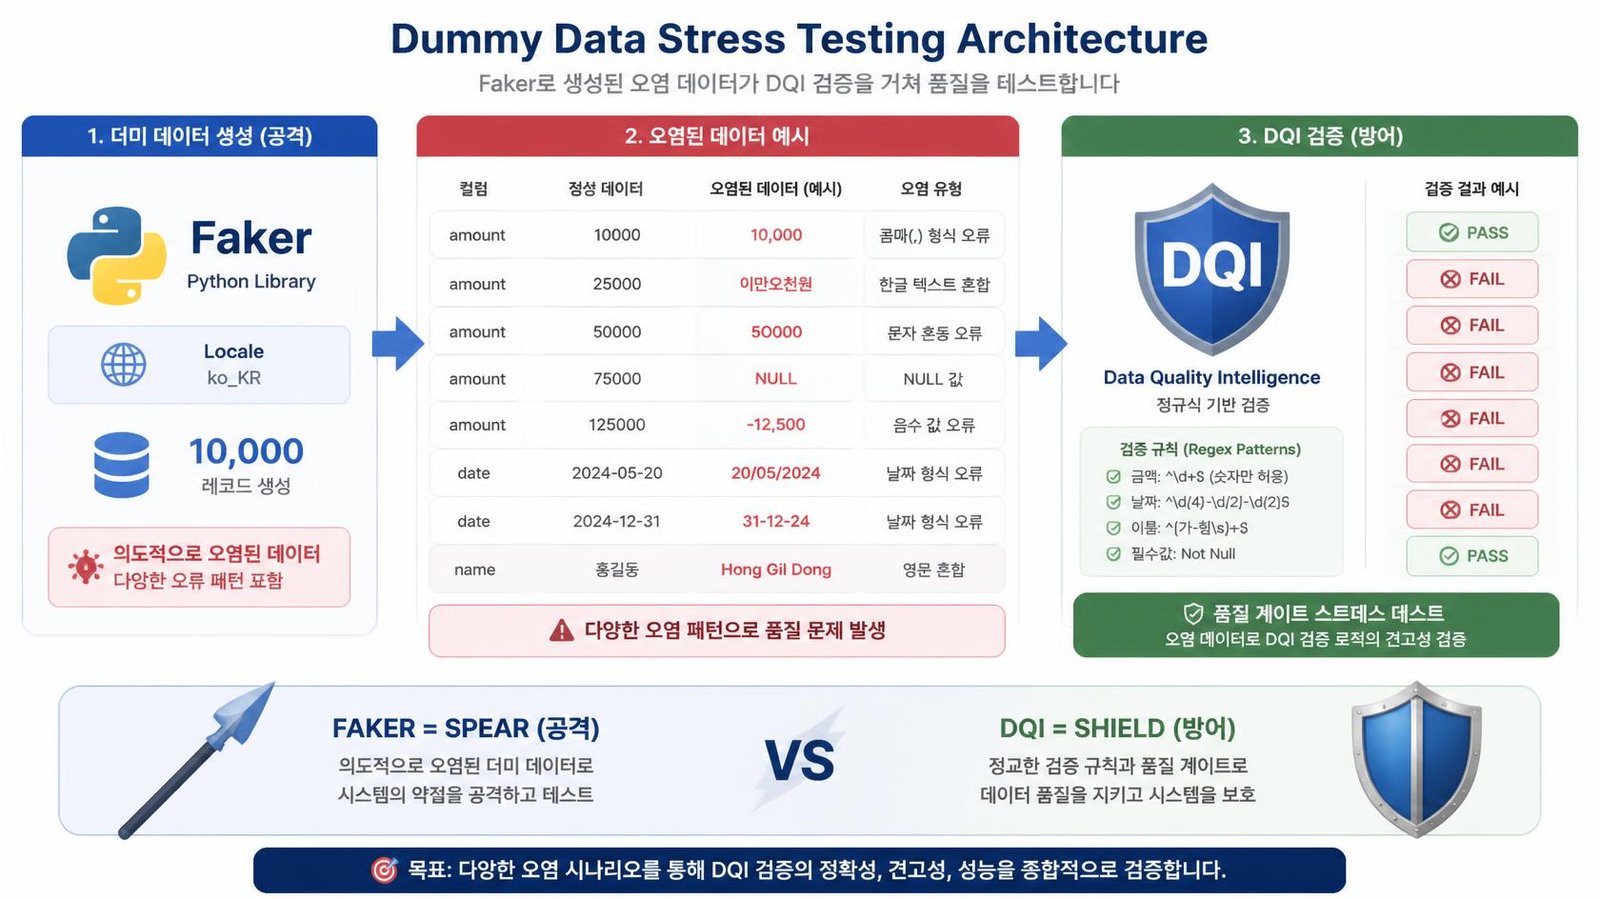
Faker로 생성한 오염 데이터가 DQI 검증을 통과/실패하는 과정을 나타낸 다이어그램

일반적으로 IT 분야나 코딩 입문 단계에서 더미데이터(Dummy Data)의 뜻을 검색하면, 단순히 ‘빈 공간을 채우기 위해 임의로 집어넣는 의미 없는 가짜 데이터’라는 사전적 정의를 마주하게 됩니다. 하지만 엔터프라이즈 데이터 거버넌스와 빅데이터 파이프라인 실무에서 더미데이터가 가지는 의미는 완전히 다릅니다. 현업 데이터 엔지니어에게 더미데이터란 우리가 구축한 데이터 품질 지표(DQI) 검증 시스템이 극한의 에러 상황에서도 무너지지 않는지 시험하기 위해 … 더 읽기

파이썬(Python) pandas 활용 데이터 품질 지표(DQI) 자동 측정 실무: 2부. 정확성(Accuracy) 검증과 정규표현식(Regex) 아키텍처

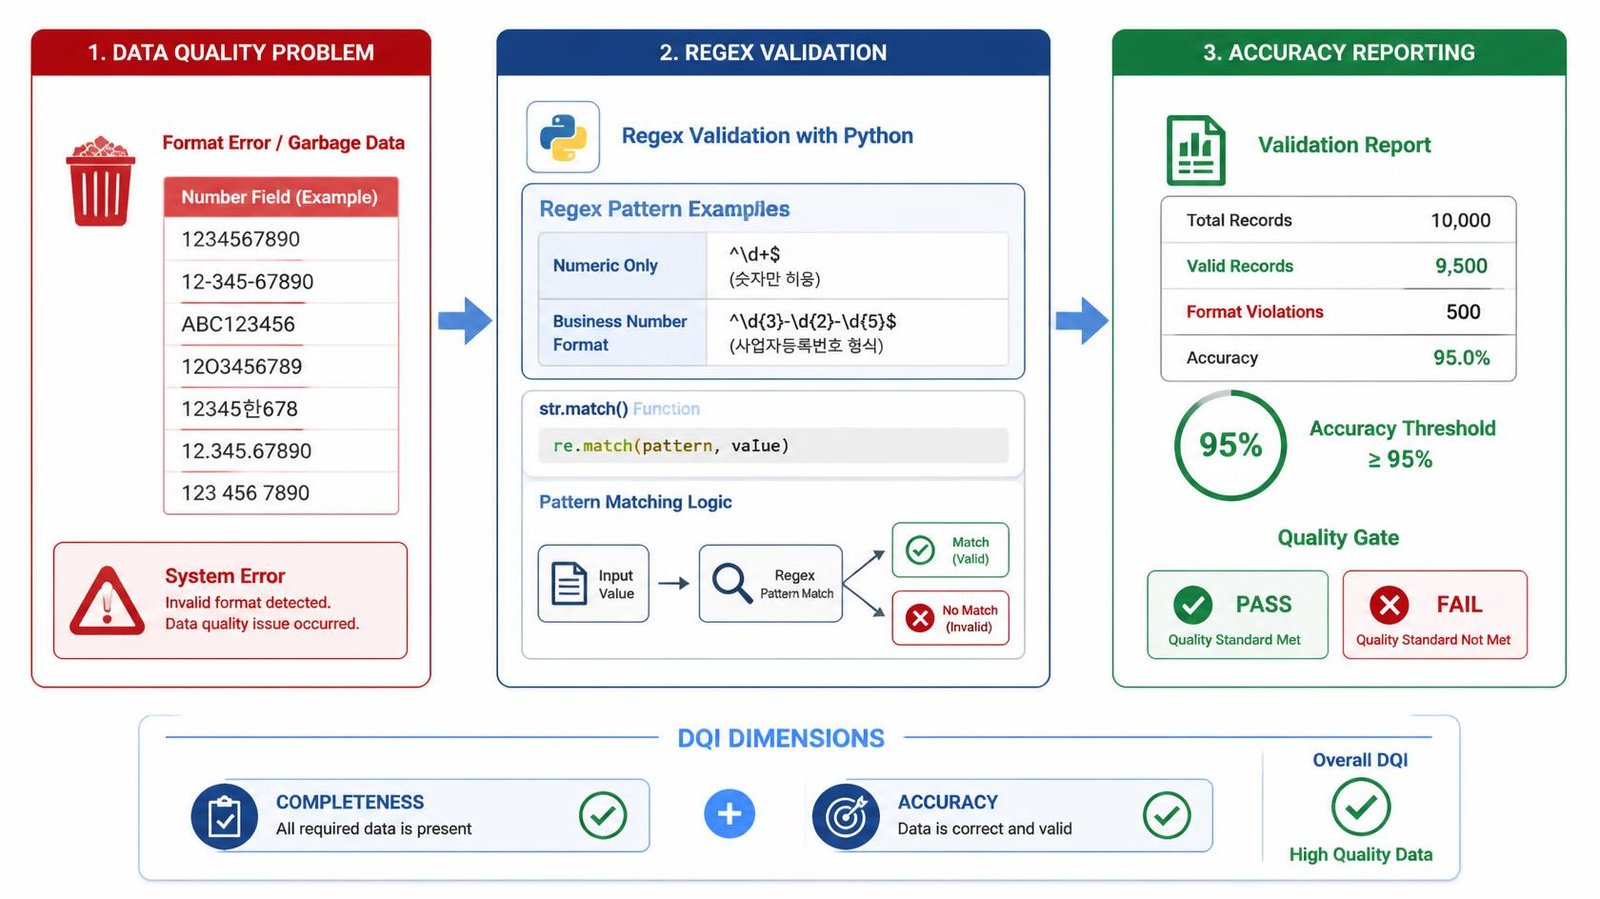
data quality accuracy DQI pipeline diagram

이전 포스팅에서 우리는 데이터의 빈칸을 찾아내는 ‘완전성(Completeness) DQI’ 자동화 파이프라인을 구축했습니다. 하지만 데이터가 100% 꽉 채워져 있다고 해서 안심할 수 있을까요? 칸은 채워져 있지만 그 안에 시스템이 읽을 수 없는 ‘쓰레기 값’이 들어있다면 파이프라인은 여전히 붕괴합니다. 본 문서에서는 실제 G2B 및 LH 공공입찰 데이터를 다루며 겪었던 포맷 불량 사태를 바탕으로, 파이썬(Python) pandas와 정규표현식(Regex)을 융합하여 데이터의 … 더 읽기

파이썬(Python) pandas 활용 데이터 품질 지표(DQI) 자동 측정 실무: 1부. 완전성(Completeness) 검증과 결측치 방어 아키텍처

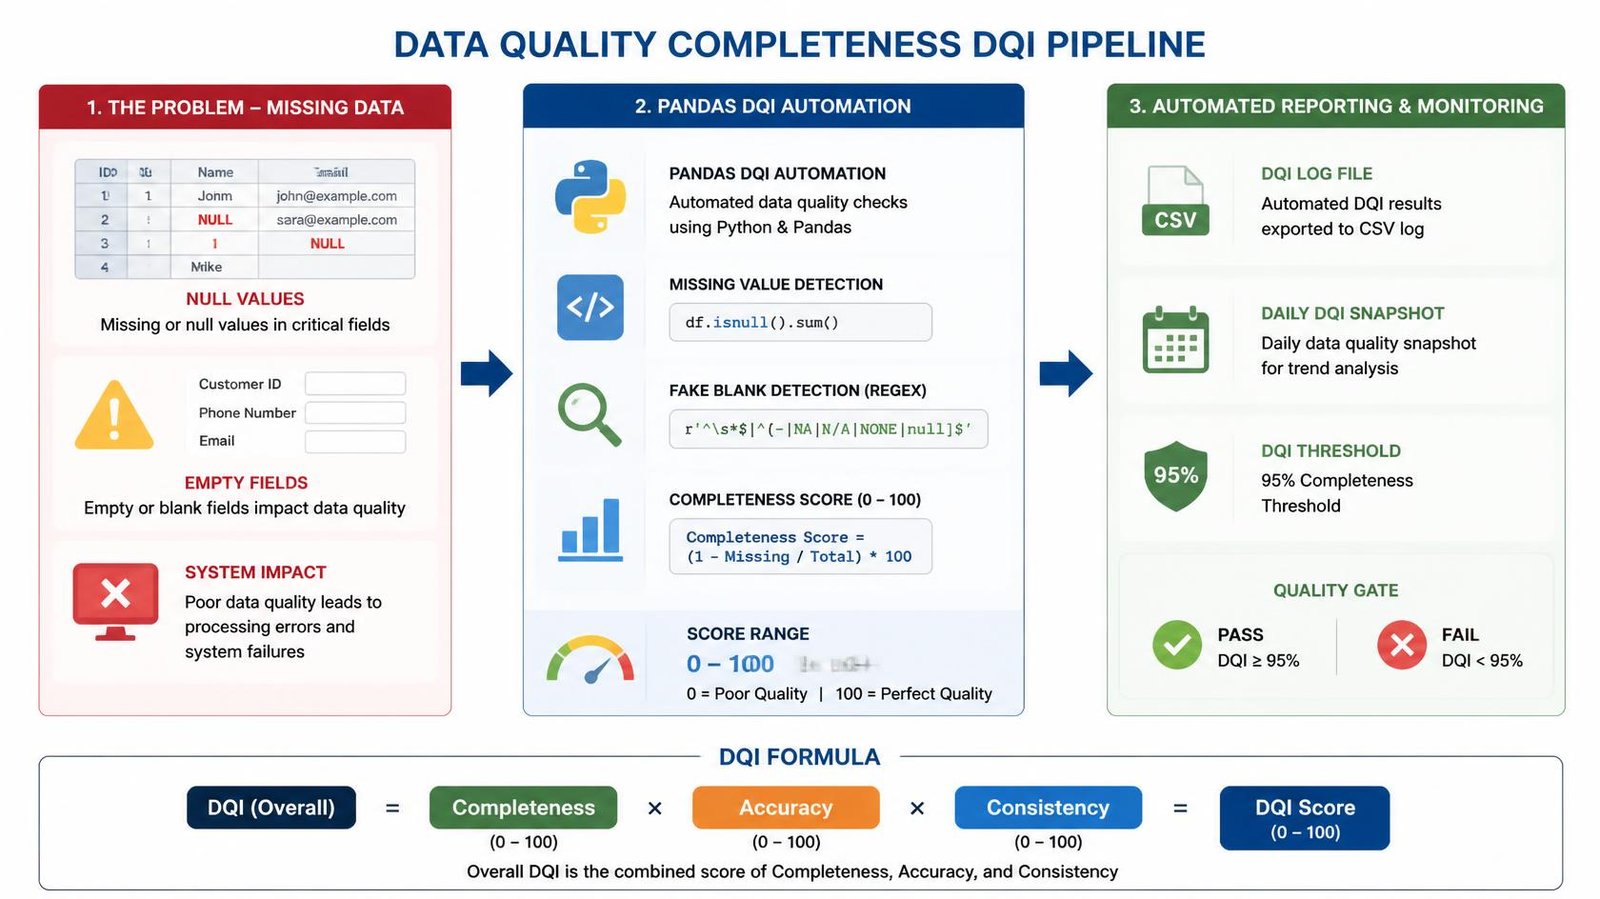
data quality completeness DQI pipeline diagram

데이터 거버넌스를 구축할 때 많은 기업이 ‘데이터 품질 지표(DQI)’라는 개념을 도입하지만, 이를 실제 현장의 파이프라인에 코드로 녹여내는 기업은 극소수에 불과합니다. DQI는 엑셀에 수동으로 기록하는 보고서가 아니라, 데이터가 유입되는 즉시 시스템이 스스로 측정하고 경고를 울려야 하는 ‘살아있는 방어막’이어야 합니다. 본 문서에서는 실제 공공입찰(G2B, LH) 데이터를 파이썬으로 수집하며 겪었던 치명적인 결측치(Null) 사태를 바탕으로, pandas 라이브러리를 활용해 DQI의 … 더 읽기

시스템 감사 트레일(Audit Trail) 로깅 아키텍처 구축 및 로그 무결성 검증 실무

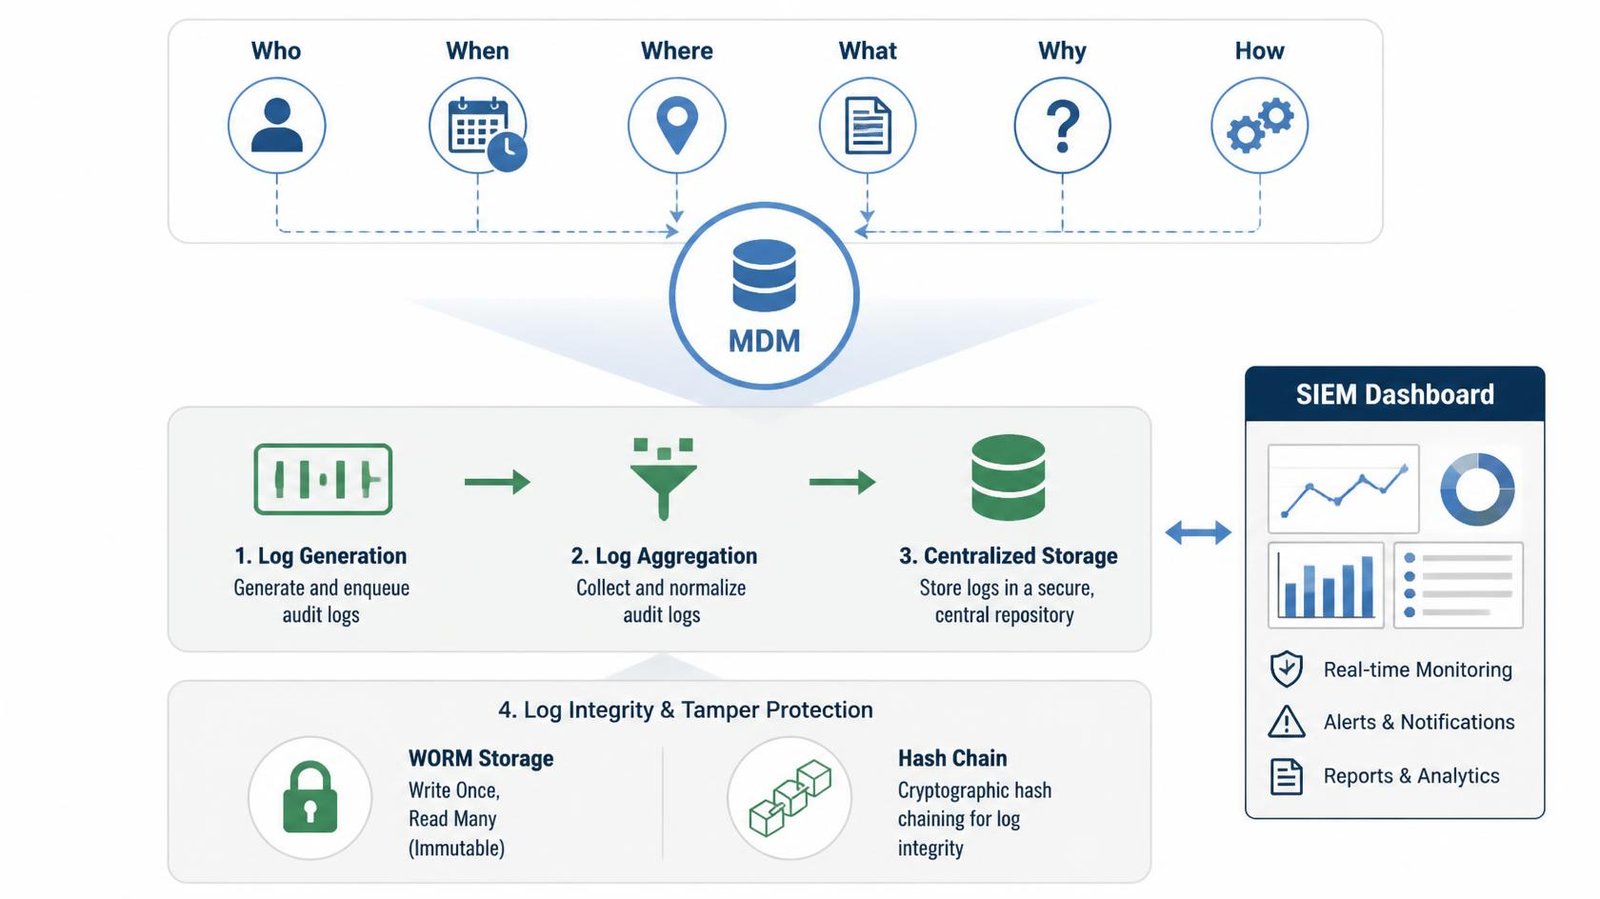
Clean audit trail logging architecture

우리는 지금까지 마스터 데이터 관리(MDM) 환경을 보호하기 위해 접근 권한(RBAC)을 통제하고, 스토리지 데이터를 암호화(KMS)하며, 엔드포인트의 유출 경로(DLP)를 철통같이 차단하는 강력한 3중 방어선을 구축했습니다. 하지만 제로 트러스트(Zero Trust) 보안 아키텍처의 관점에서 보면, ‘내부의 적’은 언제나 존재합니다. 합법적인 최고 권한을 가진 데이터베이스 관리자나 임원 계정이 탈취되었을 때, 이 방어선들은 무용지물이 될 수 있습니다. 따라서 엔터프라이즈 보안의 최종 … 더 읽기

오픈소스 기반 MDM 솔루션 도입 시 고려해야 할 라이선스 및 성능 최적화 요인

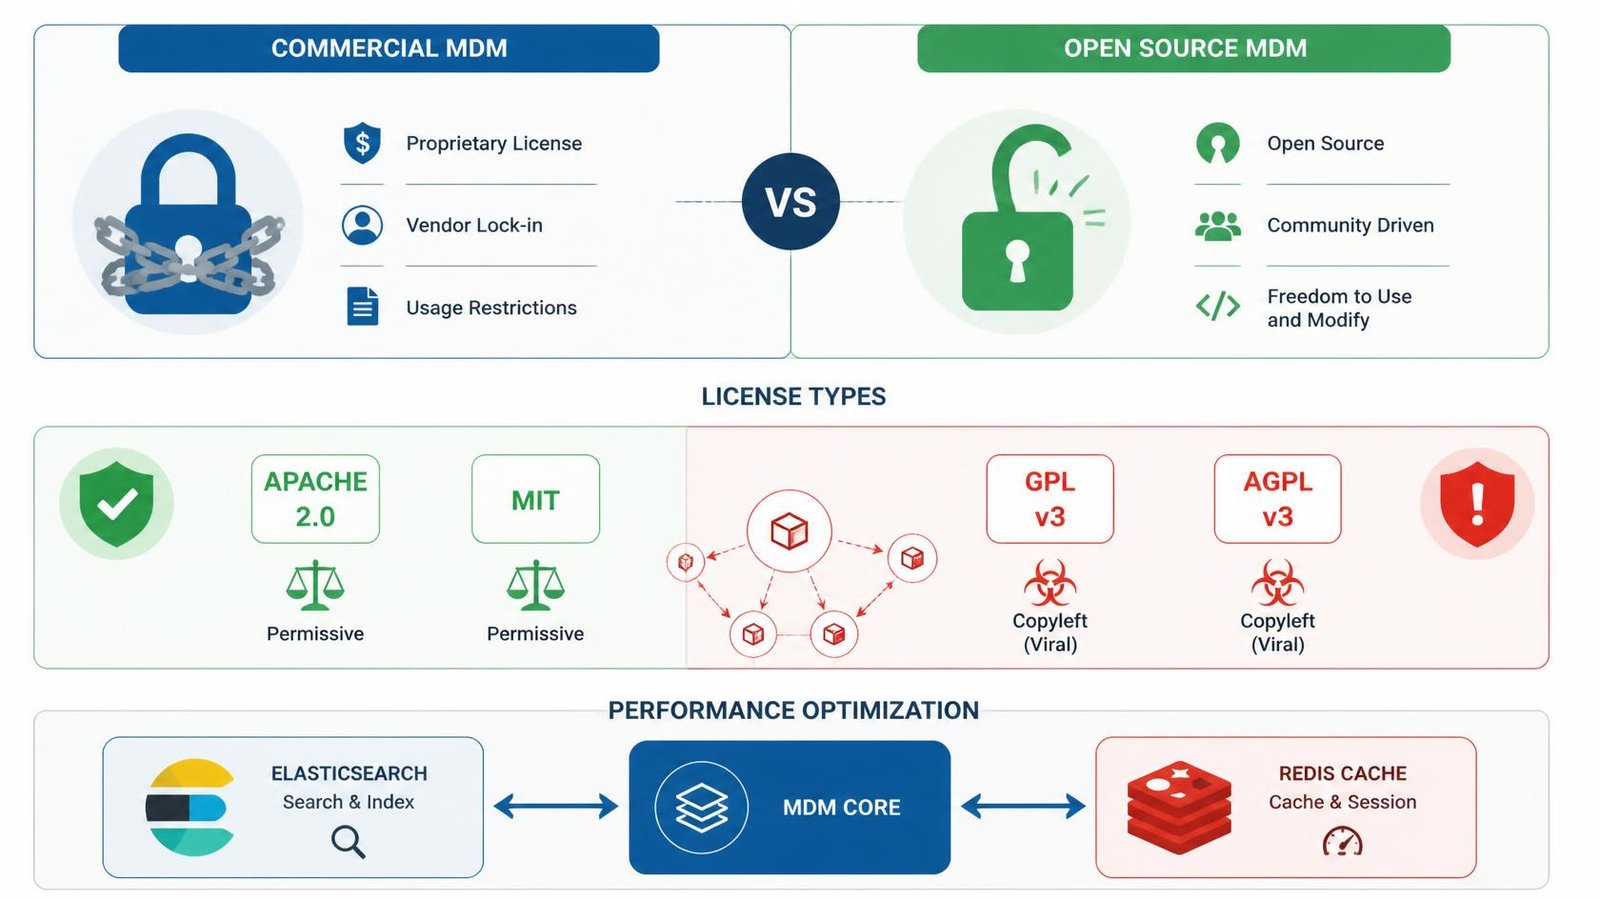
comparing commercial MDM

기업의 마스터 데이터 관리(MDM) 아키텍처를 클라우드로 성공적으로 이관했다면, 다음으로 직면하는 가장 큰 고민은 “어떤 MDM 소프트웨어를 사용할 것인가?”입니다. 과거에는 막대한 초기 도입 비용(License Fee)을 지불하고 글로벌 벤더사의 상용 솔루션을 도입하는 것이 당연시되었습니다. 하지만 최근 마이크로서비스 아키텍처(MSA)와 클라우드 네이티브 환경이 표준으로 자리 잡으면서, 벤더 종속성(Vendor Lock-in)을 탈피하고 유연성을 극대화할 수 있는 오픈소스(Open Source) 기반 MDM 솔루션이 … 더 읽기

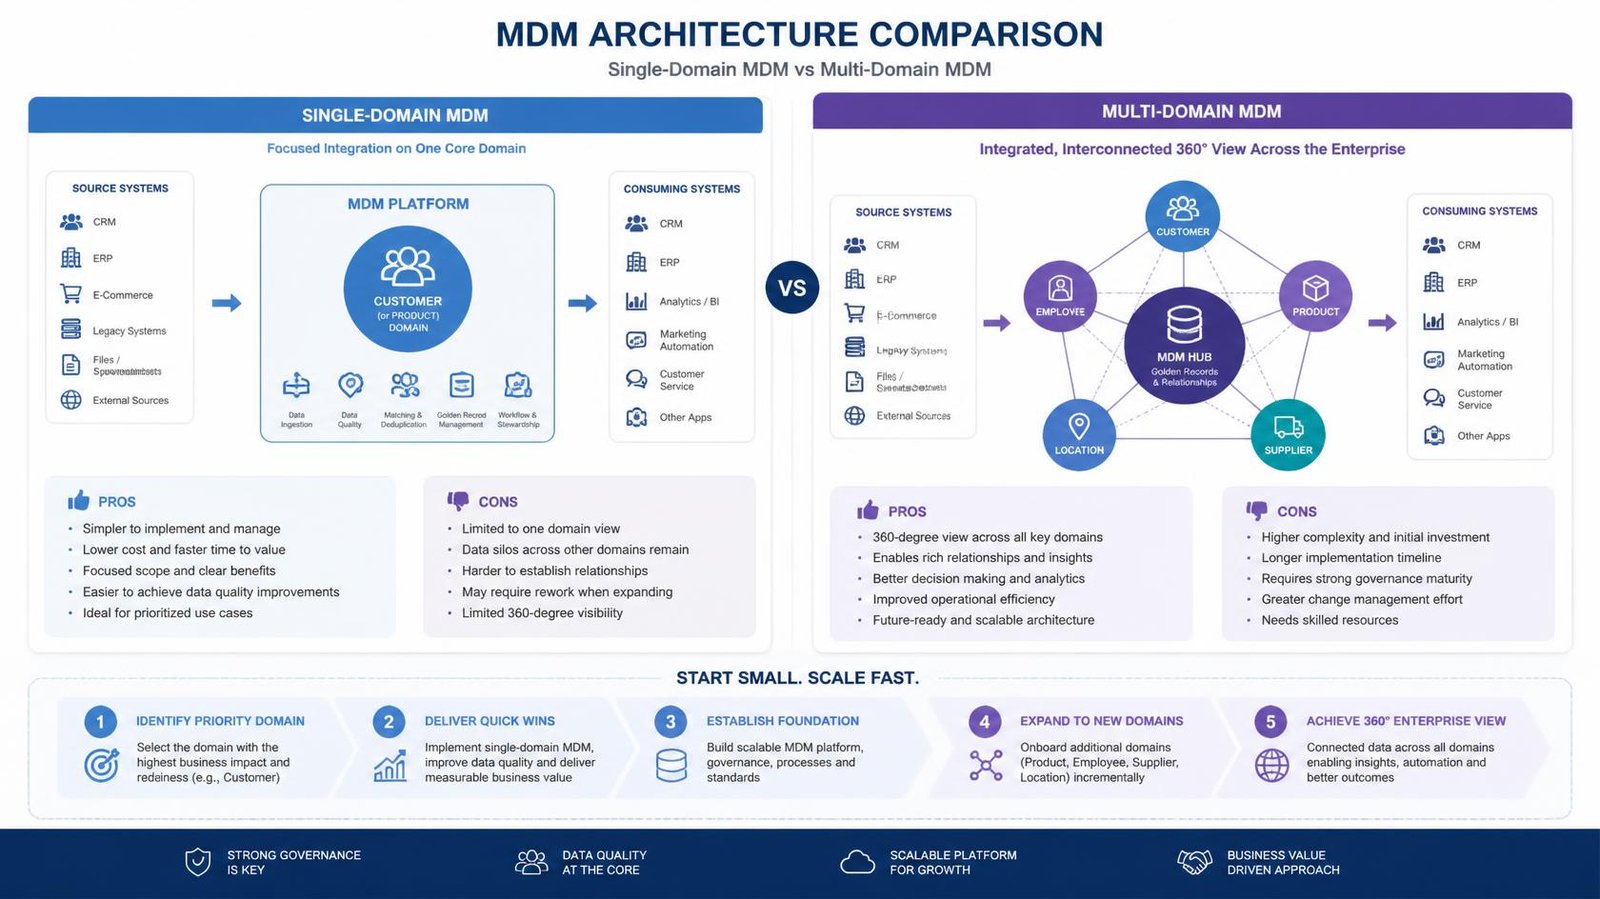
멀티 도메인(Multi-Domain) MDM 모델과 싱글 도메인 모델의 시스템 구조 비교

MDM architecture comparison diagram

엔터프라이즈 데이터 거버넌스의 기반을 다지고 품질(DQI)을 확보했다면, 이제 본격적으로 마스터 데이터 관리(MDM) 시스템의 물리적, 논리적 아키텍처를 설계할 차례입니다. MDM 프로젝트의 성패를 가르는 첫 번째 중대한 결정은 바로 “어떤 데이터를 통합할 것인가?” 즉, ‘데이터 도메인(Data Domain)’의 범위를 설정하는 것입니다. 본 문서에서는 MDM 시스템 설계의 양대 산맥인 싱글 도메인(Single-Domain) 모델과 멀티 도메인(Multi-Domain) 모델의 아키텍처 구조를 비교 분석하고, … 더 읽기