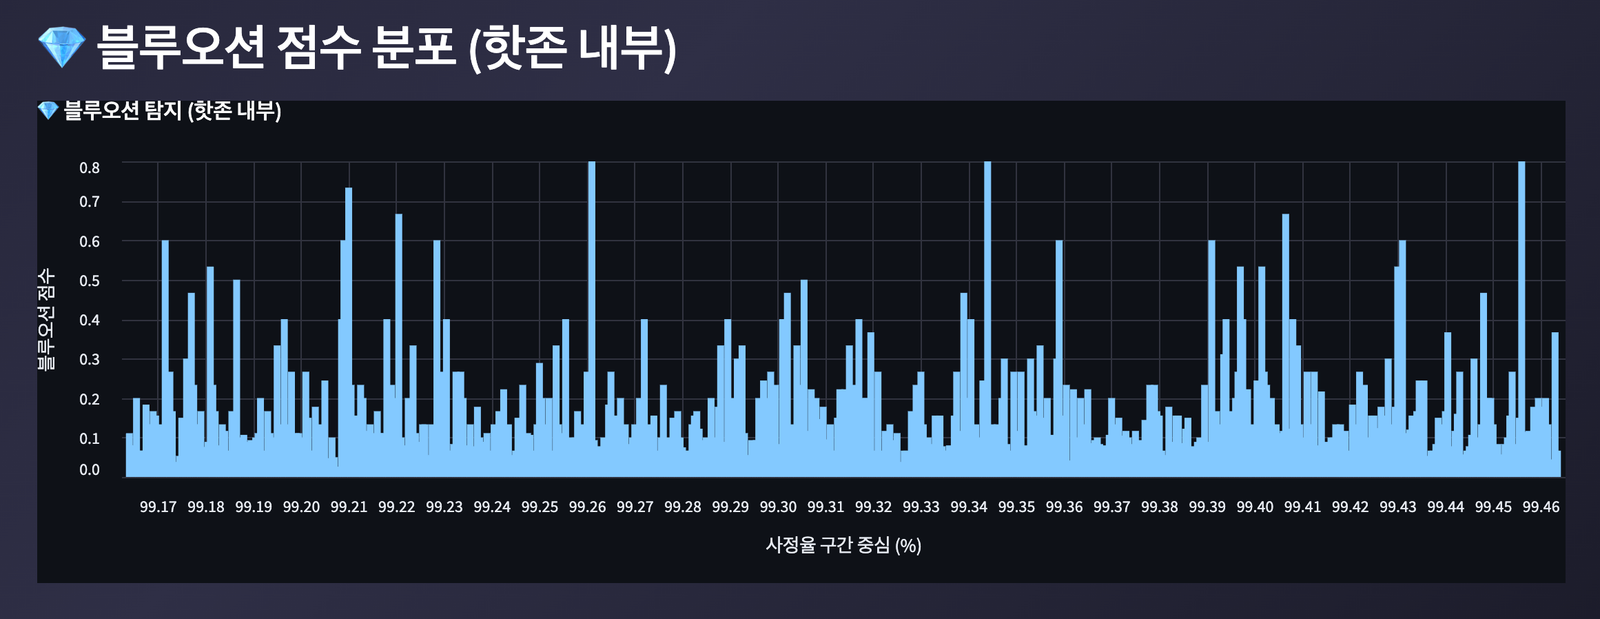
“이해를 돕기 위해 재구성한 예시 화면입니다”
1편에서 이야기한 업체명 매칭 문제를 해결하고 나니, 이제 진짜 궁금했던 걸 볼 차례였습니다. 특정 집행관의 과거 낙찰 기록을 모아서, 그 집행관 손에서 유독 자주 낙찰이 나던 사정율 구간 — 이른바 ‘핫존’을 찾아내는 작업이었습니다.
첫 시도는 단순했습니다. 과거 낙찰 데이터를 쭉 훑어보고, 눈에 띄게 낙찰이 몰려 있는 구간을 대략 잡았습니다. 99.1%에서 99.2% 사이. 얼핏 보면 꽤 좁혀놓은 것 같았습니다. 그런데 이 구간을 실제로 써보려는 순간, 생각지 못한 벽에 부딪혔습니다.
0.1%포인트 안에 숨은 또 다른 우주
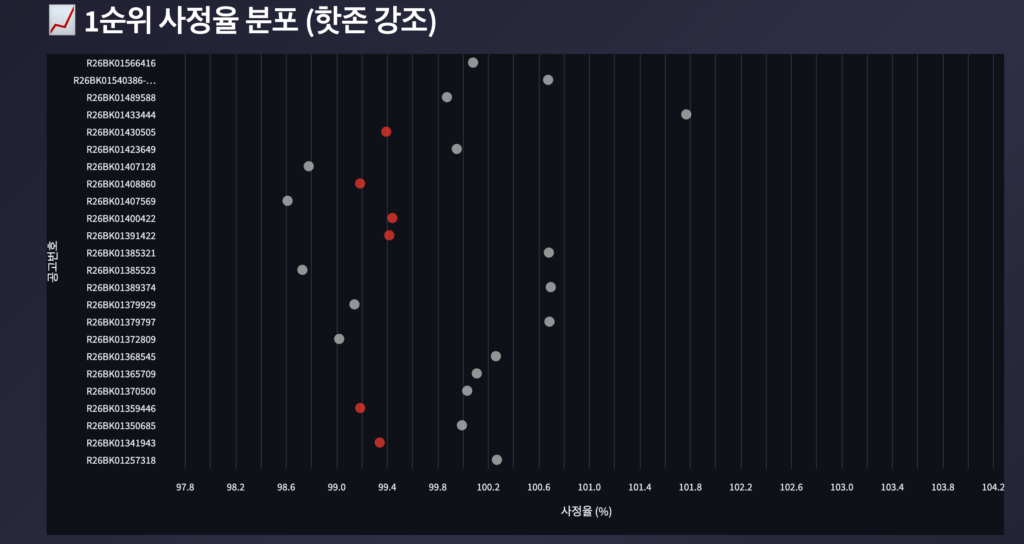
사정율은 소수점 네 자리까지 정확히 맞아야 낙찰이 결정됩니다. 즉 99.1000%와 99.1001%는 완전히 다른 값입니다. 그런데 제가 잡은 “99.1~99.2 사이”라는 구간을 다시 들여다보니, 그 안에는 이론적으로 수천 개의 서로 다른 사정율 값이 존재할 수 있는 겁니다.
실제로 과거 낙찰 데이터를 좀 더 세밀하게 뜯어보니, 이 좁아 보이던 구간 안에 이미 수많은 낙찰 예가와 참가 업체들이 빼곡하게 들어차 있었습니다. “핫존을 찾았다”고 좋아했던 게 무색하게, 정작 그 안에서 “그럼 정확히 어느 지점을 노려야 하는가”라는 질문 앞에서는 다시 원점이었습니다. 구간을 좁힌 게 아니라, 그냥 문제를 한 단계 미룬 것에 가까웠습니다.
숫자가 너무 많으면, 눈으로는 안 보인다
문제는 단순히 “범위가 넓다”는 감각적인 것이 아니라, 그 범위 안의 데이터 밀도였습니다. 사람이 엑셀 표를 스크롤하면서 “여기가 몰려있네” 하고 판단하기에는, 소수점 네 자리 단위로 흩어진 수백~수천 개의 값을 한눈에 파악하는 게 애초에 불가능했습니다. 넓은 구간을 손으로 다시 좁히려는 시도 자체가 잘못된 접근이었던 셈입니다.
여기서 방향을 바꿨습니다. “범위를 눈으로 좁힌다”가 아니라, “그 범위 안에서 값들이 실제로 어떻게 분포하는지를 통계적으로 확인한다”는 쪽으로요.
히스토그램으로 밀도가 솟구치는 지점을 찾다
과거 낙찰 데이터를 다시 꺼내서, 이번엔 단순히 범위를 눈대중으로 보는 대신 사정율 값들을 아주 촘촘한 구간(bin)으로 쪼개서 히스토그램을 그려봤습니다. 원리 자체는 간단합니다 — 넓은 구간을 잘게 쪼갠 뒤, 각 구간에 낙찰 건수가 몇 개나 몰려 있는지를 막대그래프로 확인하는 겁니다.
python
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt

# 과거 낙찰 데이터의 사정율 컬럼 (예: 99.1000 ~ 99.2000 범위)
rates = df["사정율"]

# 소수점 네 자리 단위에 맞춰 매우 촘촘하게 구간을 나눔
bins = np.arange(99.10, 99.20, 0.001)
counts, bin_edges = np.histogram(rates, bins=bins)

plt.figure(figsize=(10, 4))
plt.bar(bin_edges[:-1], counts, width=0.0008)
plt.xlabel("사정율 구간")
plt.ylabel("낙찰 건수")
plt.title("사정율 구간별 낙찰 밀도")
plt.show()
이렇게 촘촘하게 쪼개서 그려보니, “99.1~99.2 사이” 전체가 고르게 몰려있는 게 아니라는 게 바로 눈에 들어왔습니다. 그 안에서도 유독 막대가 솟구쳐 올라오는 특정 구간이 있었고, 나머지는 상대적으로 뜨문뜨문했습니다. 넓은 평지처럼 보였던 구간이, 사실은 몇 개의 뾰족한 봉우리와 넓은 골짜기로 이루어져 있었던 겁니다.
좁힌다는 것의 진짜 의미
이 작업을 겪으면서 깨달은 건, “핫존을 좁힌다”는 게 단순히 상한값과 하한값의 폭을 줄이는 문제가 아니라는 점이었습니다. 폭을 아무리 줄여도 그 안의 데이터가 균일하게 퍼져 있다면 여전히 답을 못 찾는 것이고, 반대로 폭이 넓어 보여도 그 안에 뚜렷한 밀도 차이가 있다면 그 차이 자체가 답이 되는 겁니다. 눈대중으로 범위를 잡는 것과, 실제 분포를 통계적으로 들여다보는 것 사이에는 생각보다 큰 차이가 있었습니다.
물론 이렇게 찾아낸 밀집 구간이 다음 낙찰에도 그대로 반복된다는 보장은 없습니다. 과거 데이터가 보여주는 건 어디까지나 확률적인 경향이지, 정답이 아니기 때문입니다. 이 도구가 할 수 있는 건 가능성이 높은 구간을 좁혀주는 것까지입니다.
다음 편에서는 이렇게 정리된 파이프라인을 실제로 돌리다가 겪었던 세 번째 난관 — 잘 돌아가던 화면이 갑자기 로딩 스피너만 돌고 멈춰버렸던, API 호출 제한을 몸으로 배운 경험을 다루겠습니다.

경기도 하남 미사에서 부동산 중개 비즈니스를 운영하며 G2B 공공입찰 데이터 파이프라인을 직접 설계한 데이터 엔지니어입니다. 18년간 수학 교육 현장에서 다져온 논리적 사고력으로 데이터 거버넌스와 MDM을 다룹니다.
https://jjubis.com/about-jjubis/