1편에서는 업체명 검색 조건 하나 때문에 결과가 뒤죽박죽이 됐던 이야기를, 2편에서는 넓게만 잡았던 핫존 구간을 히스토그램으로 좁혀나간 이야기를 했습니다. 이번 편은 분석 로직이 아니라 그보다 한 단계 앞, 데이터를 가져오는 단계에서 막혔던 이야기입니다. 솔직히 말하면 세 편 중에서 가장 허무하게 막혔고, 가장 허무하게 풀린 문제였습니다.
잘 돌던 분석기가 어느 순간 멈췄다
분석기의 데이터는 공공데이터포털에서 발급받은 API로 가져옵니다. 처음에는 아무 문제가 없었습니다. 공고번호를 넣으면 데이터를 당겨와서 분석 결과를 착실하게 뽑아줬습니다.
그런데 어느 순간부터 결과가 나오지 않았습니다. 화면에는 로딩 스피너만 하염없이 돌았고, 기다려도 데이터는 오지 않았습니다. 코드를 바꾼 것도 아니고, 어제까지 멀쩡하던 기능이 오늘 갑자기 안 되는 상황. 개발을 해본 분이라면 이게 얼마나 사람을 답답하게 만드는지 아실 겁니다. 내 코드가 잘못된 건지, 서버가 잘못된 건지, 아니면 그냥 오늘 운이 나쁜 건지조차 알 수 없으니까요.
원인은 내가 부른 호출 횟수였다
원인을 찾고 나니 오히려 당연한 결과였습니다. 문제는 제가 데이터를 가져오는 양이었습니다.
공공입찰, 특히 물품 관련 입찰은 공고 한 건에 참가 업체가 6,000곳 정도 들어오는 경우가 있습니다. 분석을 위해서는 이 업체들의 정보를 전부 가져와야 했습니다. 게다가 공고 한 건만 보는 게 아니었습니다. 분석의 정확도를 높이려고, 지금 보려는 공고와 관련된 지난 2년치 입찰 데이터를 모조리 함께 긁어오고 있었습니다.
공고 하나에 업체 수천 곳, 그런 공고가 2년치. 한 번 분석을 돌릴 때마다 API 호출이 순식간에 불어나는 구조였던 겁니다. 그러다 결국 API 호출량 제한에 걸려버렸고, 제한에 걸린 순간부터 데이터가 더 이상 내려오지 않았던 겁니다. 스피너는 열심히 돌았지만, 사실 기다릴 데이터가 애초에 오지 않는 상태였습니다.
해결: 개발계정을 운영계정으로 전환하다
알아보니 해결 방법은 의외로 간단했습니다. 공공데이터포털의 API는 처음 활용 신청을 하면 개발계정으로 승인됩니다. 이름 그대로 개발하고 테스트해보라는 용도의 계정이라, 호출할 수 있는 양이 넉넉하지 않게 제한되어 있습니다. 실제 서비스에서 본격적으로 쓰려면 운영계정으로 전환해야 하고, 이때 그 데이터를 어디에 어떻게 쓰고 있는지 활용사례를 등록해야 합니다.
저는 분석기를 실제로 운영하고 있는 사이트를 활용사례로 등록하고 계정 변경을 신청했습니다. 운영계정으로 바뀌고 나니 문제는 깔끔하게 해결됐습니다. 며칠을 붙잡고 있던 스피너가, 서류 한 장으로 멈춘 셈입니다.
같은 문제를 겪고 계신 분을 위해 정리하면 이렇습니다.
- 잘 되던 API가 갑자기 데이터를 안 준다면, 코드보다 먼저 오늘 호출량이 계정의 허용량을 넘었는지부터 의심해보세요.
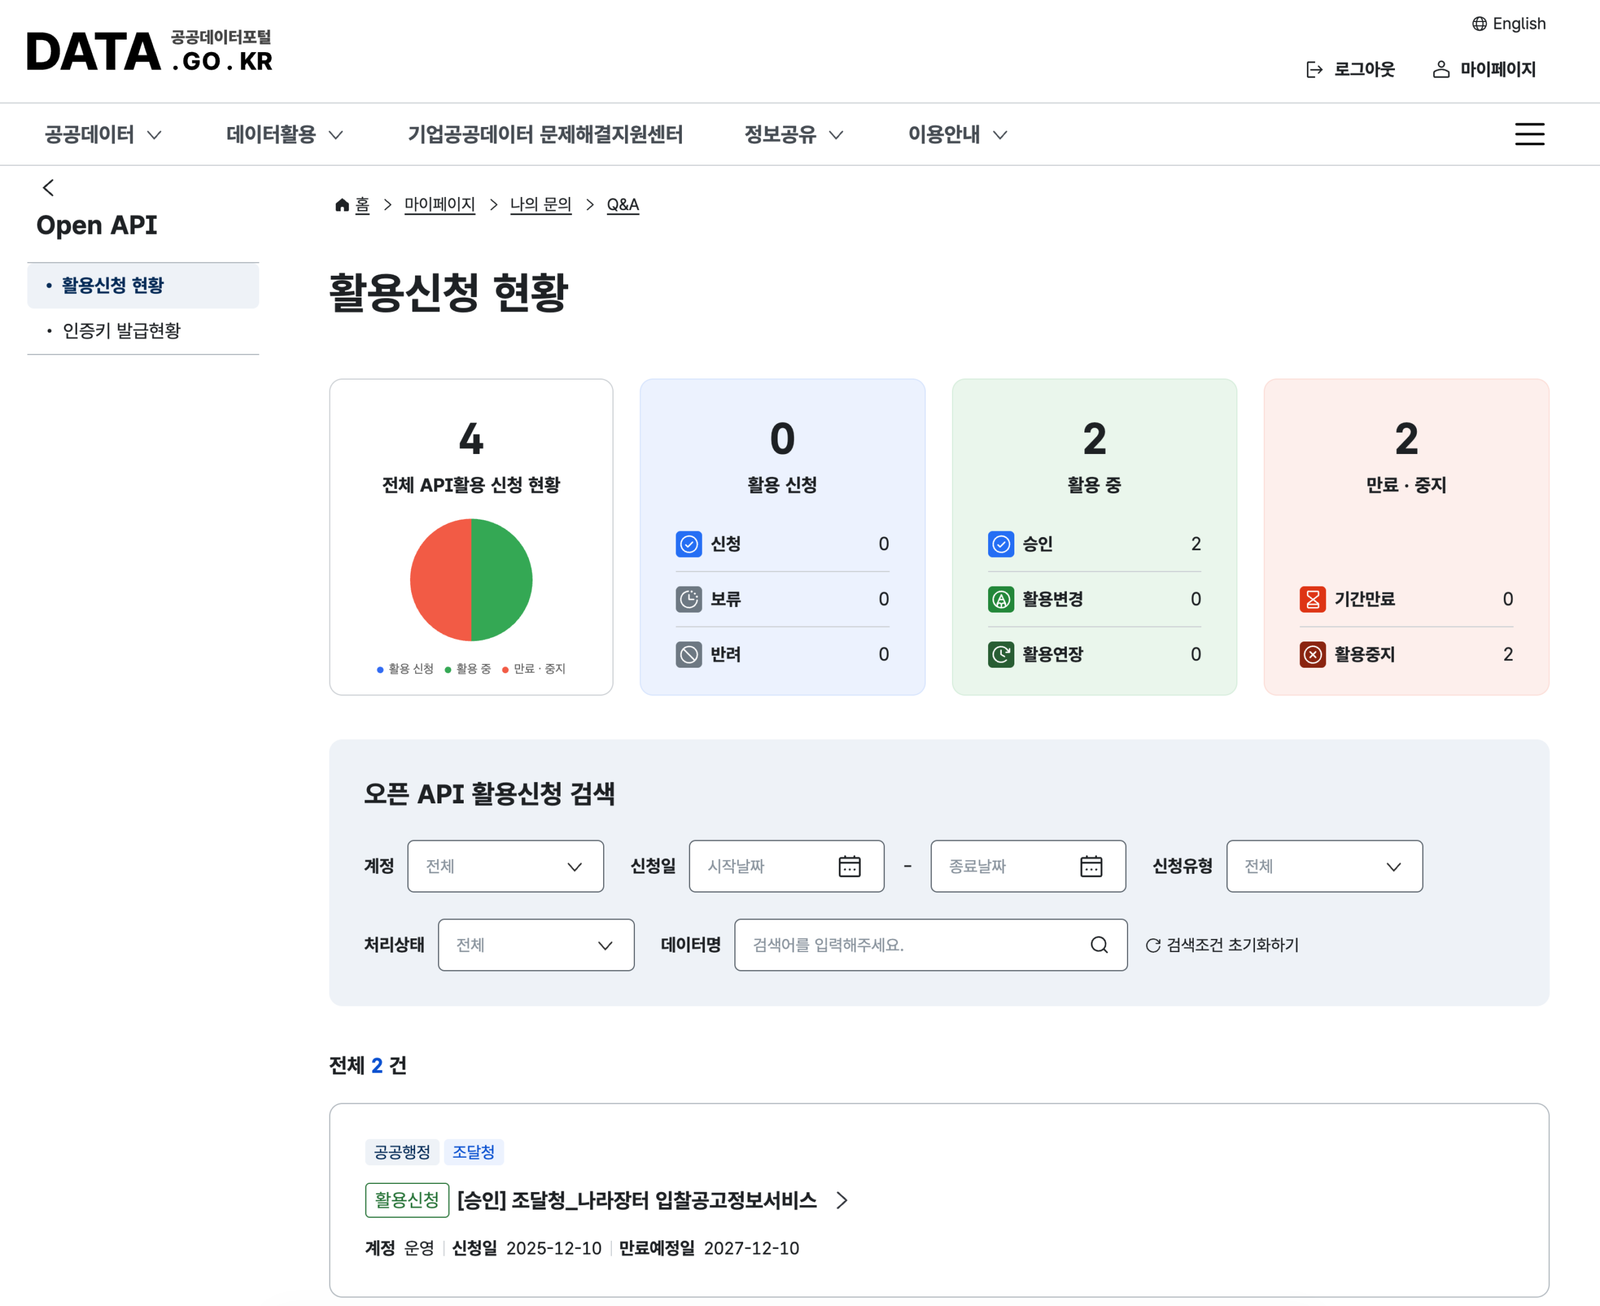
- 공공데이터포털 마이페이지 → Open API → 활용신청 현황에서 신청한 API마다 계정이 ‘개발’인지 ‘운영’인지 표시됩니다. 저도 이 화면에서 조달청 나라장터 입찰공고정보서비스가 ‘운영’ 계정으로 바뀐 것을 확인했습니다. API마다 허용량이 다르니, 사용 중인 API의 허용량도 함께 확인해두는 게 좋습니다.
- 실제 서비스에 쓰고 있다면 운영계정 전환을 신청하고, 그 데이터를 활용하는 사이트나 서비스를 활용사례로 등록하면 됩니다.
이 경험이 알려준 것
데이터 거버넌스라고 하면 보통 데이터의 품질, 표준, 정합성을 먼저 떠올립니다. 이 시리즈의 1편과 2편도 그런 이야기였고요. 그런데 이번 일을 겪으면서, 데이터가 어디서 어떤 조건으로 들어오는지를 아는 것도 그만큼 중요하다는 걸 배웠습니다. 아무리 정교한 품질 검증 로직을 짜두어도, 데이터가 들어오는 통로가 막히면 그 뒤의 모든 것이 멈춥니다.
분석을 돌리기 전에 “이번 작업이 API를 대략 몇 번이나 부르게 될까”를 한 번 가늠해보는 것, 그리고 내가 쓰는 계정이 그만큼을 감당할 수 있는지 확인하는 것. 지나고 보면 별것 아닌데, 이 단계를 건너뛰면 저처럼 스피너만 바라보며 며칠을 보내게 됩니다.
시리즈를 마치며
세 편에 걸쳐 1365 사정율 분석기를 만들면서 부딪힌 문제들을 기록했습니다. 검색 조건 한 줄이 결과를 오염시킨 일, 넓기만 하던 구간을 통계로 좁혀나간 일, 그리고 데이터 통로 자체가 막혔던 일까지. 돌아보면 셋 다 화려한 알고리즘의 문제가 아니라, 당연하다고 넘겨짚었던 부분에서 터진 문제였습니다.
마지막으로 솔직하게 덧붙이자면, 이 분석기가 실제 낙찰을 얼마나 맞혔는지 사후 분석을 해보려 해도 “맞혔다, 틀렸다”로 딱 잘라 말하기가 어렵습니다. 낙찰이라는 것 자체가 워낙 예측불허이기 때문입니다. 이 도구가 할 수 있는 건 정답을 알려주는 게 아니라, 과거 데이터를 근거로 가능성이 높은 범위를 좁혀주는 것까지입니다. 그 한계를 알고 쓸 때, 데이터는 비로소 도구가 됩니다.

경기도 하남 미사에서 부동산 중개 비즈니스를 운영하며 G2B 공공입찰 데이터 파이프라인을 직접 설계한 데이터 엔지니어입니다. 18년간 수학 교육 현장에서 다져온 논리적 사고력으로 데이터 거버넌스와 MDM을 다룹니다.
https://jjubis.com/about-jjubis/